


四、DataStream API
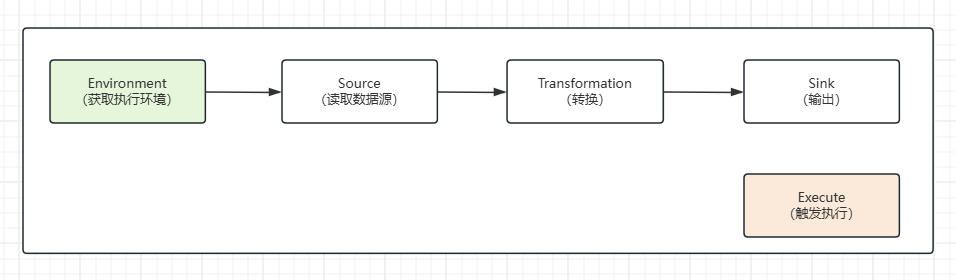
1. 执行环境(Execution Environment)
Flink 程序可以在各种上下文环境中运行,在提交作业执行计算时,须先获取当前 Flink 的运行环境,从而建立起与 Flink 框架的联系,构建不同环境对应的运行过程
1.1 创建执行环境
(1)getExecutionEnvironment
// 如:程序独立运行,则返回本地执行环境
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
(2)createLocalEnvironment
// 该方式可以显示传入并行度参数,默认值为当前host的cpu核心对应的线程数
StreamExecutionEnvironment localEnv = StreamExecutionEnvironment.createLocalEnvironment();
(3)createRemoteEnvironment
StreamExecutionEnvironment remoteEnv = StreamExecutionEnvironment
          .createRemoteEnvironment(
            "host",                   // JobManager主机名
            8088,                     // JobManager进程端口号
               "xxx/xxx/jarFile.jar"     // 提交给 JobManager 的 jar 包
        );
1.2 执行模式(Execution Mode)
Flink 官方从 1.12 版本开始,推荐使用 DataStream API,在提交任务时将执行模式设置为 BATCH 进行批处理
DataStream API 执行模式:
- 流执行模式(Streaming)
- 批执行模式(Batch)
- 自动模式(AutoMatic):该模式根据数据数据源是否有界自动选择执行模式
设置方式:
命令行
bin/flink run -Dexecution.runtime-mode=BATCH ...
代码
// 实际业务场景中不推荐在代码里设置
StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
env.setRuntimeMode(RuntimeExecutionMode.BATCH);
1.3 触发执行程序
Flink 是由事件驱动的,只有当数据真正输入时,才会触发计算,即延迟执行或懒执行
在算子后须显示调用 execute() 方法,该方法会一直同步等待作业完成,返回 JobExecutionResult 执行结果
env.execute();
评论 (0)