


三、运行时架构
1. 系统架构
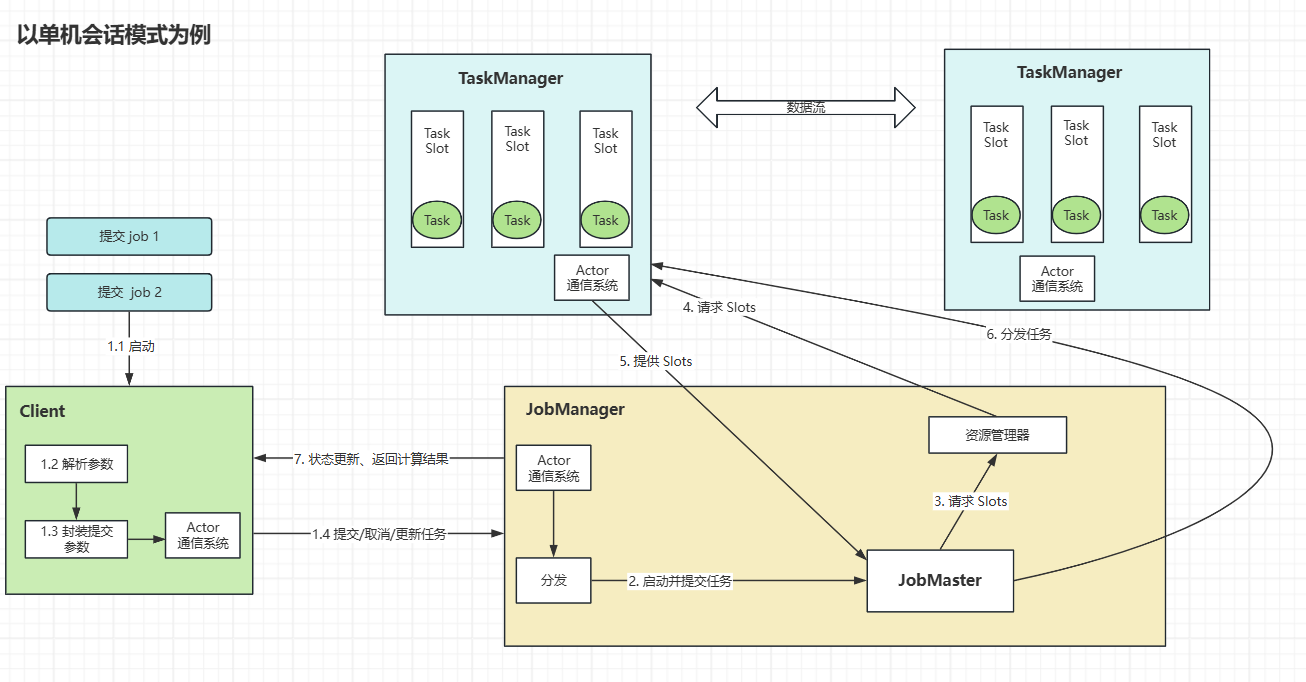
(1)JobManager 作业管理器
概念:Flink 集群中任务管理、调度的核心,控制应用执行的主进程,即:每个任务都应该被唯一的 JobManager 控制执行。
包含以下3个组件:
JobMaster
负责处理单独的作业(Job),它与具体的作业是一一对应的。当作业提交时,JobMaster 会先接收要执行的应用,将其转换为 StreamGraph 后,再转换为 JobGraph(ExecutionGraph 执行图),其包含了所有所有可以并发执行的任务,之后 JobMaster 向资源管理器(ResourceManager)申请执行任务所需的资源(Slot),并将执行图分发到执行具体任务的 TaskManager
ResourceManager(资源管理器)
主要负责资源分配和管理,资源指 TaskManager 的任务槽(Task Slots),Flink 集群中的资源调配单元,包含用于执行计算的一组 CPU 和内存资源,一个任务对应一个 Slot
Dispatcher(分发器)
提供 REST 接口和 Web UI 管理界面,用于提交应用,并且为每一个新提交的作业启动一个新的 JobMaster 组件,该组件随部署模式的不同而不同
(2)TaskManager 任务管理器
任务管理器是 Flink 的工作进程,负责计算数据流(执行具体的作业),每个任务管理器都包含一定数量的 Task Slot,Slot 是资源调度的最小单位,其数量决定了任务管理器能并行处理的任务数。不同 TaskManager 之间可以进行数据交换。
2. 核心概念
2.1 并行度(Parallelism)
(1)并行子任务和并行度
当需要处理的数据量很大时,我们可以把一个算子操作,“复制”到多个节点,数据来了之后可以在其中任一节点执行,这样一个算子任务就被拆分成了多个并行的子任务(SubTask),再将它们分发到不同的节点,就真正实现了并行计算。
在 Flink 执行过程中,一个算子(operator)可以包含一个或多个子任务,这些子任务在不同线程、不同物理机或不同容器中完全独立的执行。
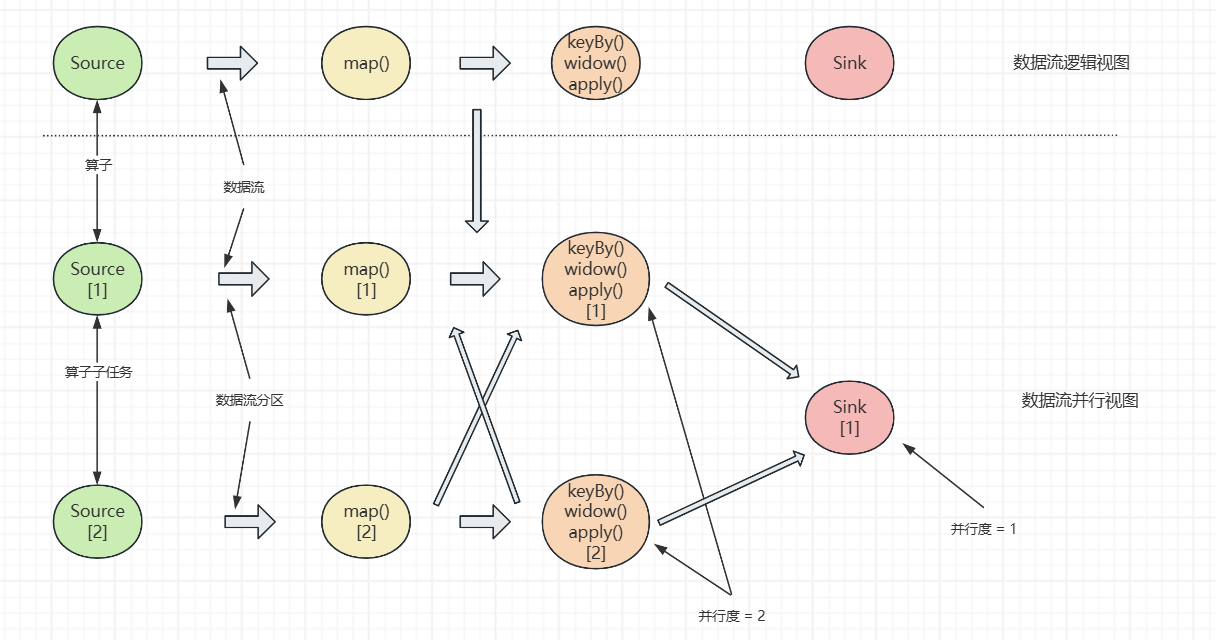
算子的子任务个数成为并行度(Parallelism),包含并行子任务的数据流称为并行数据流,它需要多个分区(Stream Partition)来分配并行任务,一个算子的最大并行度成为一个流程序的并行度
(2)设置并行度
setParallelism() 方法:
// 通过执行环境设置
env.setParallelism(2);

// 设置当前算子的并行度
stream
    .map(word -> Tuple2.of(word, 1L))
    .setParallelism(2);
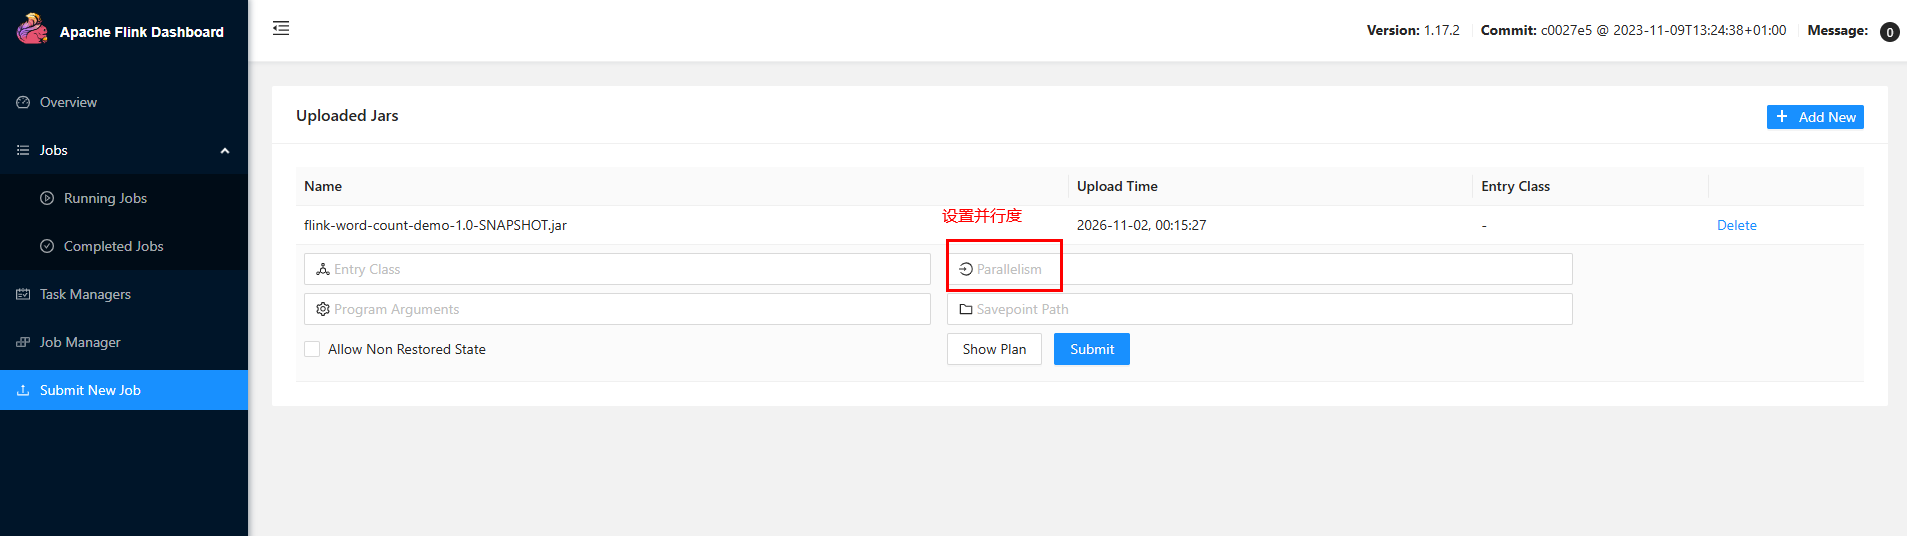
在 web ui 或命令行提交应用时设置
命令行
# -p 指定算子并行度
bin/flink run –p 2 –c [fullyQualifiedClassName] xxx.jar
web ui
conf 配置文件
# flink-conf.yaml
# 默认值为 1
parallelism.default: 1
2.2 算子链(Operator Chain)
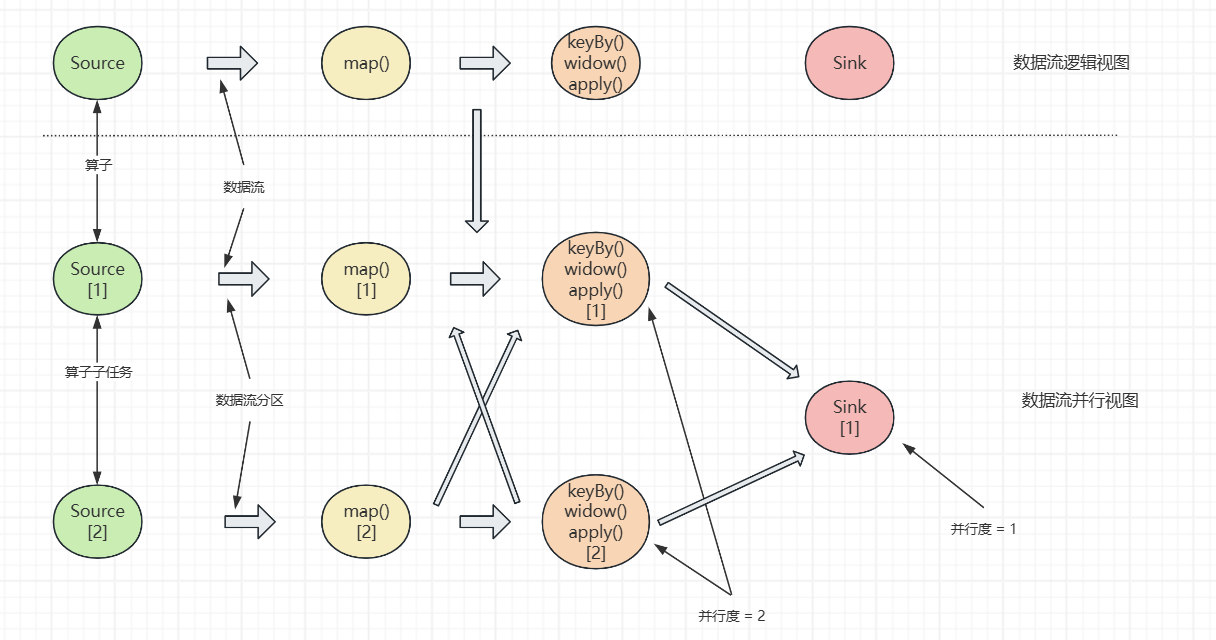
(1)算子间的数据传输
一对一(One to One, forwarding)
该模式下数据流维护分区以及元素的顺序,即 source ---> map,source 读取完数据后可以直接发送给 map 继续处理,它们之间不需要重分区,也不用调整执行顺序,map 算子的子任务看到的元素个数和顺序与 source 算子的子任务产生的完全一样,遵循“一对一”的关系
重分区(Redistricting)
该模式下的数据流分区会发生改变,如图中 map 算子之后的 keyBy/window 等算子, keyBy/window 算子与 sink 算子之间的数据流向,每个算子的子任务会根据数据传输策略,将数据发送到不同的下游目标任务,在这个过程中会发生数据重分区
(2)合并算子链
在 Flink 中,并行度相同的一对一算子操作,可以直接连接在一起形成一个大的任务,称为算子链(Operator Chain),可以减少线程上下文切换和基于缓冲区的数据交换,减少延时,提升吞吐量
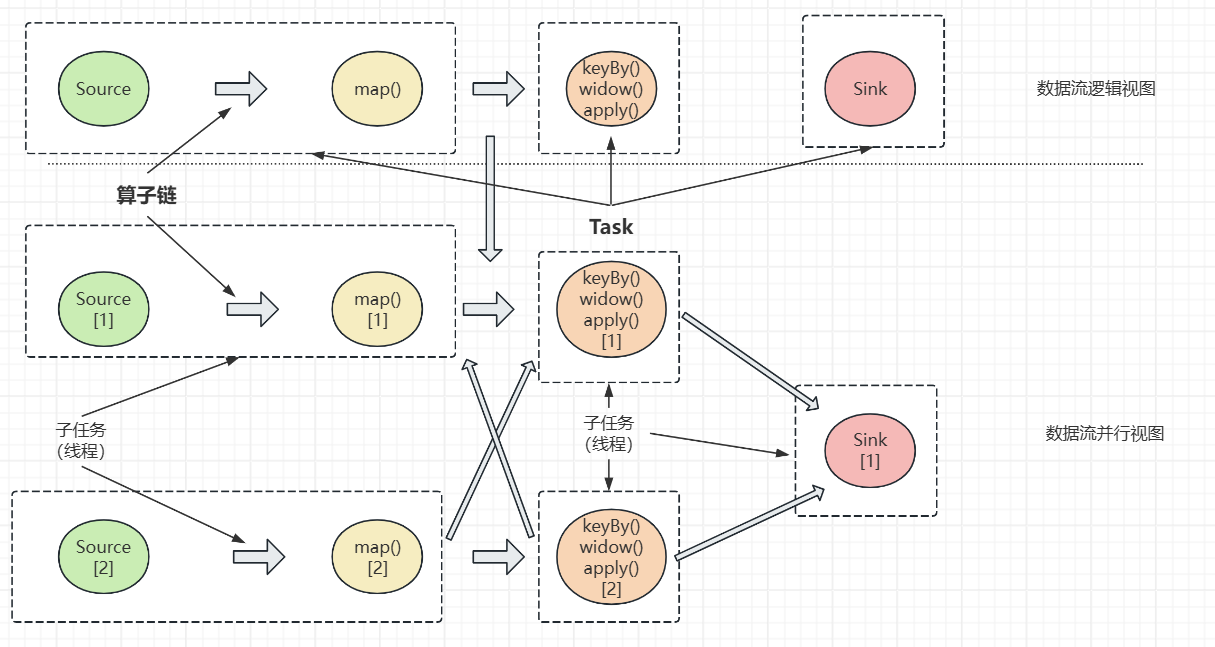
上图中 source 和 map满足算子链的要求,可以直接合并形成一个任务(并行度相同),合并之后为两个并行子任务,最终这个作业有5个任务,由5个线程并行执行
注:Flink 顶层会自动优化可合并的算子链,在业务场景需要禁用某些算子的合并操作时,可在具体的算子后通过 .disableChaining() 方法禁用
评论 (0)